앞 글의 Adam은 계산된 gradient로 parameter를 어떻게 갱신할지 정했다. 그런데 신경망 안에서 전달되는 값이 지나치게 커지거나 작아지고, layer마다 규모가 달라지면 어떨까? Optimizer만 바꾸는 것과 별개로 network 안에서 중간 값 자체를 다루는 방법도 필요하다.
Batch normalization은 한 mini-batch에서 같은 feature의 평균과 분산을 구해 값을 정규화하고, 학습 가능한 scale과 shift를 적용하는 연산이다. 이 글은 activation·초기화에서 그 필요성을 찾고, 작은 숫자로 forward를 계산한 뒤 training과 inference, backward, FullyConnectedNet 구현으로 연결한다. 마지막에는 수업과 과제에 이어지는 layer normalization을 비교한다.
| 알고 싶은 것 | 읽을 부분 |
|---|---|
| 왜 필요하고 무엇을 계산하는가? | 1–6절: activation·초기화, 정규화 축, 숫자 예제, 학습과 추론 |
| 과제의 함수를 어떻게 이해하고 연결하는가? | 7–12절: forward, 두 backward, network 연결 |
| 실험과 다른 normalization은 어떻게 읽는가? | 13–17절: 검사 순서, 초기화·batch size, LayerNorm과 CNN의 축 |
1. Activation과 초기화 다음에 왜 normalization이 나올까?
Hidden layer 하나를 다시 보자.
다음 layer는 원본 입력이 아니라 이 를 받는다. 따라서 앞 layer가 어떤 크기의 값을 내보내는지가 다음 layer의 계산과 gradient에 영향을 준다. 수업에서 activation function과 weight initialization을 먼저 살펴보는 이유다.
Activation: 값이 어느 구간에 있는지가 중요하다
Sigmoid는 입력을 0과 1 사이로 보낸다.
의 절댓값이 너무 커져 출력이 0이나 1에 가까워지면 derivative는 작아진다. Backward에서 이런 작은 값들을 여러 번 곱하면 앞 layer로 전달되는 gradient가 작아질 수 있다. 출력이 거의 변하지 않는 이 구간을 saturation(포화)이라고 한다. Tanh도 큰 절댓값의 입력에서는 포화된다.
ReLU는 양수 입력에서 derivative가 1이어서 이 문제를 줄이는 데 도움이 된다. 하지만 음수 입력은 0으로 막고, 모든 layer의 값 크기를 자동으로 맞춰 주지도 않는다. ReLU를 사용한다는 사실만으로 깊은 network의 학습 문제가 모두 해결되는 것은 아니다.
초기화: 여러 층을 지나며 값이 사라지거나 커지지 않게 시작하기
Weight가 지나치게 작으면 값과 gradient가 여러 층을 지나며 작아질 수 있다. 반대로 너무 크면 값이 커지거나 포화 영역으로 들어갈 수 있다. 단순히 작은 난수를 넣는 것에서 나아가 입력 수에 맞춰 분산을 조절한다.
| 초기화의 출발점 | Weight의 표준편차 | 생각할 것 |
|---|---|---|
| Xavier의 단순한 fan-in 형태 | 입력 수가 많아지면 각 weight의 규모를 줄인다 | |
| He 초기화의 fan-in 형태 | ReLU가 일부 값을 0으로 만드는 효과까지 고려한다 |
은 해당 layer로 들어오는 feature 수다. 예를 들어:
W = np.random.randn(D_in, D_out) * np.sqrt(2.0 / D_in)처럼 ReLU용 초기화를 할 수 있다. 과제에서 weight_scale로 초기화 규모를 비교하는 실험은 이 시작 조건의 영향을 살펴보는 것이다.
모든 hidden weight를 같은 값으로 초기화하면 같은 역할의 neuron들이 같은 계산과 gradient를 받아 서로 다른 특징을 배우기 어렵다. 그래서 weight에는 서로 다른 난수를 사용한다. Bias를 0으로 초기화하는 것은 별개의 문제다.
초기화는 학습 시작 시점을 조절한다. 하지만 학습이 진행되면 weight가 바뀌고, 다음 layer가 받는 값도 계속 달라진다. 여기서 중간 값을 network 안에서 직접 정규화하는 방법으로 넘어간다.
2. 입력 전처리와 BatchNorm은 무엇이 다를까?
원본 입력의 평균을 빼면 첫 layer가 받는 데이터의 중심을 맞출 수 있다. 평균을 학습 데이터에서 계산했다면 validation·test에도 그 평균을 사용한다. Validation·test를 섞어 전처리 통계를 구하면 평가에 사용할 데이터의 정보가 학습 과정에 들어간다.
하지만 입력을 정리해도:
를 거친 중간 값의 평균·분산이 입력과 같을 이유는 없다. BatchNorm은 각 hidden layer 내부의 값에 정규화 연산을 넣는다.
수업과 초기 논문에서는 앞 layer의 parameter가 바뀌며 내부 입력 분포가 달라지는 문제를 internal covariate shift라는 말로 소개한다. 이 용어를 외우는 것보다, 무엇을 어느 축으로 정규화하고 그 연산을 어떻게 미분하는지를 먼저 이해하는 편이 중요하다. BN이 중간 값의 모든 분포 변화나 학습의 어려움을 없앤다는 뜻은 아니다.
BN은 feature별 평균·분산을 조절한다. Feature 사이의 상관관계를 모두 제거하는 whitening이나, 값을 특정 정규분포로 바꾸는 연산은 아니다.
3. 어디에 넣고, 어느 축으로 계산할까?
이번 fully connected 과제의 hidden block은 다음 순서다.
Affine → BatchNorm → ReLUHidden layer가 둘이면:
입력 → Affine → BN → ReLU → Affine → BN → ReLU
     → 마지막 Affine → class scores → softmax loss
마지막 class score에는 BN을 붙이지 않는다. 여기의 BN은 ReLU를 대체하지도 않는다. BN은 값의 중심·규모를 조절하고, ReLU는 음수와 양수를 다르게 처리하는 activation이다.
BN이 받는 x는 원본 이미지일 필요가 없다
batchnorm_forward(x, ...)의 x는 보통 바로 앞 affine layer가 만든 값이다. Shape가 (N, D)라면:
N: 이번 mini-batch의 sample 수.D: 해당 layer에서 sample 하나가 갖는 feature, 즉 hidden unit의 수.x[i, j]: i번째 sample이 j번째 hidden unit에서 낸 값.
예를 들어:
는 sample 3개, feature 2개다. BN은 첫 feature의 [1, 3, 5]와 두 번째 feature의 [10, 14, 18]를 각각 따로 정규화한다.
                    feature 1   feature 2
sample 1                1          10
sample 2                3          14
sample 3                5          18
                        ↓           ↓
평균·분산              따로 계산    따로 계산
NumPy에서는 sample 방향을 줄이는 axis=0이다. 한 sample의 feature들을 가로로 평균내는 axis=1은 뒤에서 볼 LayerNorm의 방향이다.
4. Forward를 숫자로 끝까지 계산하기
Feature j에 대해 mini-batch의 평균과 분산을 구한다.
평균 는 값의 중심, 분산 는 중심에서 떨어진 정도의 제곱평균이다. 표준편차는 분산의 제곱근이다. 이 과제에서는 분산을 N-1이 아니라 N으로 나눈다. np.var(x, axis=0)의 기본 계산과 같다.
정규화한 값은:
은 분산이 0이거나 매우 작을 때 나눗셈을 안정화하는 작은 양수다. 분산에 epsilon을 더하고 제곱근을 취한다. 분산으로 직접 나누거나, 제곱근 바깥에 epsilon을 더하는 식으로 바꾸면 다른 계산이 된다.
첫 feature [1, 3, 5]
을 잠시 무시하면 표준편차는 이다.
작은 값은 평균보다 아래라 음수, 큰 값은 평균보다 위라 양수다. 가운데 값은 평균과 같으므로 0이다. 정규화된 세 값은 평균이 0이고 분산이 1이다.
실제 인 계산에서는 정규화 결과의 분산이 정확히는 이므로 1보다 조금 작다. 따라서 과제의 “평균 0, 표준편차 1”은 수치 오차와 epsilon을 고려해 가까운지 확인하는 말이다.
두 번째 feature [10, 14, 18]도 자기 평균 14와 분산 을 사용하면 같은 정규화값을 얻는다. 두 열은 정규화 후에도 서로 완전히 같은 패턴이다. 이 예만 보아도 BN이 feature 사이의 상관관계를 제거하는 연산은 아니라는 것을 알 수 있다.
5. 정규화한 다음 gamma와 beta는 왜 붙일까?
모든 layer가 무조건 평균 0·분산 1인 값만 내보내야 한다면 표현을 지나치게 제한할 수 있다. BN은 정규화한 값에 학습 가능한 scale과 shift를 적용한다.
는 gamma(감마), 는 beta(베타)라고 읽는다. Feature마다 gamma 하나와 beta 하나가 있다. 같은 feature의 gamma·beta는 batch의 모든 sample이 공유한다.
앞 절의 첫 feature에 , 을 적용하면:
중심은 10, 표준편차는 약 2가 된다. Gamma가 음수라면 값의 방향도 뒤집히며 표준편차는 부호를 갖지 않으므로 약 다.
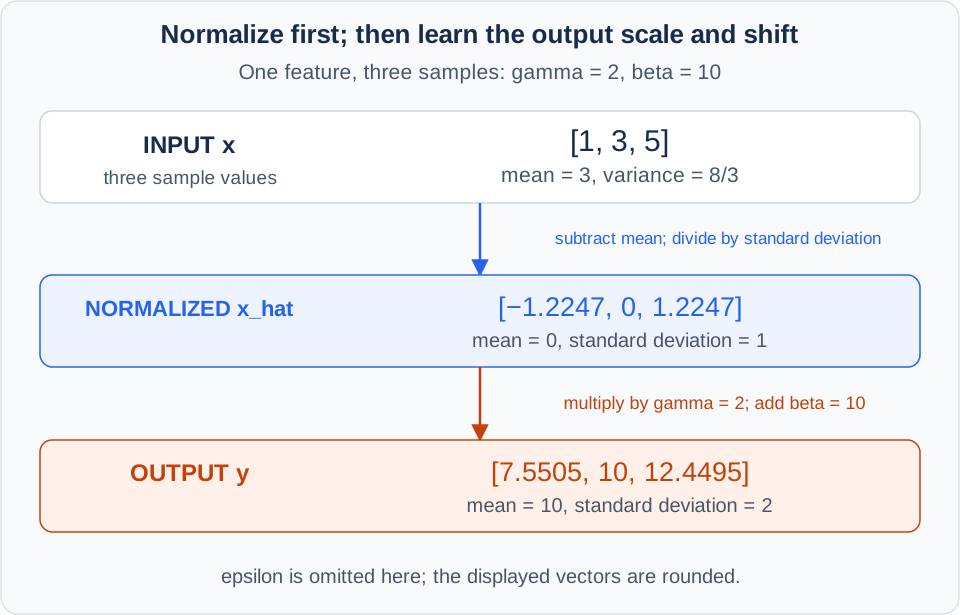
위에서 아래로 현재 batch의 통계로 정규화 → 학습하는 gamma·beta 적용을 나눠 보자. 가운데 값이 평균 0·표준편차 1에 맞춰지는 것이고, 최종 출력의 중심과 규모는 gamma·beta에 따라 다시 달라진다. 그림은 epsilon을 생략한 계산이며 벡터의 표시값은 반올림했다.
| 값 | Shape | 어디서 생기는가? |
|---|---|---|
x, x_hat, out | (N, D) | sample마다 feature D개 |
mean, var | (D,) | 이번 batch에서 계산 |
gamma, beta | (D,) | gradient로 학습하는 parameter |
running_mean, running_var | (D,) | 여러 training batch의 통계를 누적한 상태 |
초기에는 보통 gamma를 1, beta를 0으로 둔다. 이 초기 설정은 정규화 결과를 그대로 내보낸다는 뜻이다. 이후에는 loss의 gradient로 둘을 학습한다. Gamma에 매번 batch의 표준편차를 복사하고 beta에 평균을 복사하는 것이 아니다.
수업의 “원래 값을 복원할 수도 있다”는 설명은 고정된 통계에 대해 생각하면 이해하기 쉽다. , 로 두면:
즉 scale·shift를 선택할 자유가 있다. 다만 학습 중 통계는 batch마다 달라지므로 하나의 고정된 gamma·beta가 모든 batch에서 항상 BN을 완전히 상쇄한다는 뜻은 아니다.
또한 BN의 beta는 Adam의 beta1·beta2와 다른 변수다. 전자는 학습하는 출력 이동량이고, 후자는 optimizer가 과거 gradient를 얼마나 기억할지 정하는 hyperparameter다.
6. Training과 inference에서 왜 계산이 다를까?
학습에서는 지금 mini-batch의 평균과 분산을 사용한다. 그런데 예측할 때 이미지 한 장만 들어오면 어떨까?
Fully connected BN에서 N=1로 현재 sample 자체의 평균·분산을 구하면 각 feature의 평균은 그 feature 값이고 분산은 0이다.
입력이 달라도 출력이 beta만 남는다. Sample이 여러 개여도 예측을 함께 묶은 상대 sample에 따라 결과가 달라지는 것은 바람직하지 않다. 그래서 inference에서는 학습 중 저장한 통계를 사용한다.
Running mean과 running variance
이번 과제의 갱신 방식은:
momentum=0.9이면 이전 기록의 90%, 새 batch 통계의 10%를 섞는다. 앞 글의 이동평균과 같은 계산 구조지만 기억하는 대상은 gradient가 아니라 activation의 통계다. Optimizer의 Momentum과도 역할이 다르다.
예를 들어 처음 running mean이 0이고 첫 batch mean이 3이면 0.3이 된다. 다음 batch mean이 5이면 이다. 이 값은 전체 training set의 평균을 한 번에 구한 값과 정확히 같은 것은 아니다.
코드는 running standard deviation이 아니라 running variance를 저장한다. 예측에서 분모를 만들 때 제곱근을 취한다.
Training을 거치지 않았거나 학습한 통계를 불러오지 않았다면, 초기값 0인 running 통계로 올바른 예측을 기대할 수 없다.
| 구분 | mode="train" | mode="test" |
|---|---|---|
| 정규화에 사용할 통계 | 현재 mini-batch | 저장된 running 통계 |
| Running 통계 갱신 | 한다 | 하지 않는다 |
| Gamma·beta | 현재 학습 parameter | 학습된 parameter |
| Backward용 cache | 남긴다 | 이 과제의 일반적인 추론에서는 필요 없다 |
추론에서 통계와 gamma·beta를 고정하면:
따라서 feature별 affine 변환이 된다. 수업에서 이전 affine·convolution 연산과 합칠 수 있다고 설명한 이유다. 반면 training에서는 평균·분산이 입력에 의존하므로 이들을 상수처럼 취급해 미분하면 안 된다.
7. batchnorm_forward 코드와 cache
이제 과제 인터페이스에 맞춰 위 계산을 옮겨 보자. 아래 함수들은 import numpy as np를 전제로 한다. x는 부동소수점 (N,D) 배열이고, gamma·beta는 (D,)다.
def batchnorm_forward(x, gamma, beta, bn_param):
    mode = bn_param["mode"]
    eps = bn_param.get("eps", 1e-5)
    momentum = bn_param.get("momentum", 0.9)
    D = x.shape[1]
    running_mean = bn_param.get("running_mean", np.zeros(D, dtype=x.dtype))
    running_var = bn_param.get("running_var", np.zeros(D, dtype=x.dtype))
    cache = None

    if mode == "train":
        mean = np.mean(x, axis=0)
        var = np.var(x, axis=0)
        xc = x - mean
        inv_std = 1.0 / np.sqrt(var + eps)
        x_hat = xc * inv_std
        out = gamma * x_hat + beta
        cache = (x_hat, gamma, xc, inv_std)

        running_mean = momentum * running_mean + (1 - momentum) * mean
        running_var = momentum * running_var + (1 - momentum) * var
    elif mode == "test":
        x_hat = (x - running_mean) / np.sqrt(running_var + eps)
        out = gamma * x_hat + beta
    else:
        raise ValueError('Invalid batchnorm mode: "%s"' % mode)

    bn_param["running_mean"] = running_mean
    bn_param["running_var"] = running_var
return out, cachexc는 centered x, 즉 평균을 뺀 값이다. inv_std는 표준편차의 역수다. (N,D)에서 (D,)를 빼거나 곱하면 broadcasting으로 같은 feature의 통계를 모든 sample에 적용한다.
cache에는 나중에 backward가 필요로 할 정규화 값·gamma·중심화 값·역표준편차를 남긴다. 이것은 현재 forward를 미분하기 위한 기록이다. bn_param에 보존한 running 통계는 다음 batch와 추론에도 살아 있어야 할 상태다. 둘을 구분해야 한다.
이 코드의 cache 구조를 사용할 때는 뒤의 backward도 같은 구조로 맞춰 쓴다. 서로 다른 구현에서 가져온 forward와 backward는 cache 구성까지 맞는지 확인한다. 과제의 epsilon 설정 키는 "eps"라는 점도 확인하자.
8. Backward에서 sample끼리 왜 연결될까?
앞 글의 affine layer는 한 sample의 입력이 그 sample의 출력에만 영향을 줬다. BN에서는 같은 feature의 sample들이 평균·분산을 공유한다.
Feature 하나에 sample 세 개가 있으면:
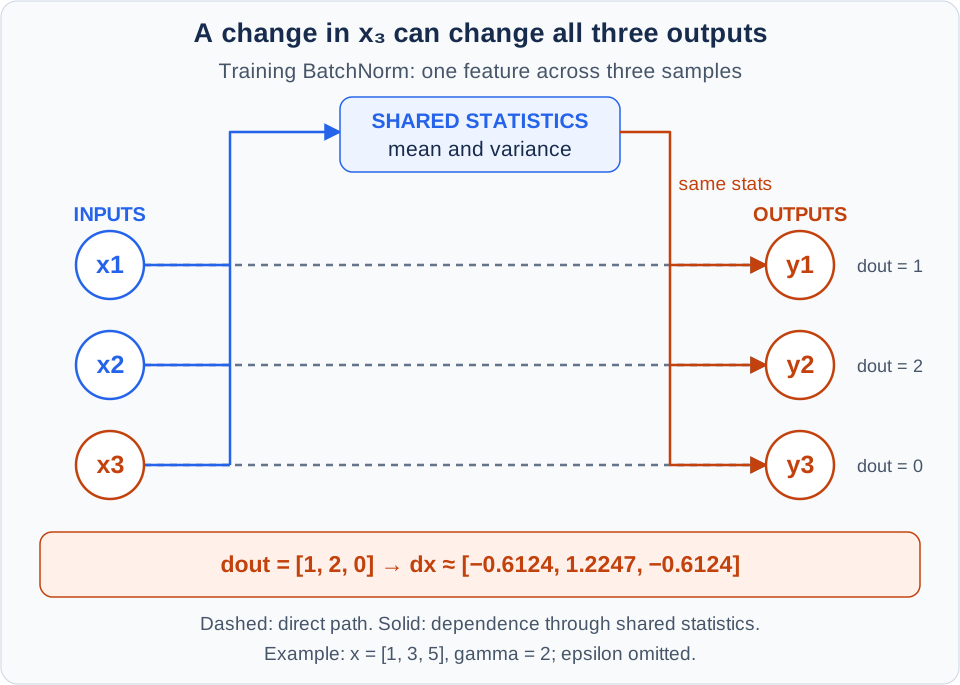
점선은 자기 출력으로 이어지는 직접 의존관계, 실선은 batch 통계를 공유하는 의존관계다. 화살표는 forward에서 무엇이 무엇에 영향을 주는지 표시한다. Backward는 이 연결을 거꾸로 따라가 모든 기여를 더한다. 아래 숫자는 11절에서 계산할 예제로, 직접 받은 dout이 0이어도 공유 경로의 기여는 남을 수 있다는 것을 보여준다.
x1을 바꾸면 평균과 분산도 바뀌므로 x_hat2, x_hat3까지 달라질 수 있다. 따라서 dx1을 구하려면 자기 출력에서 직접 오는 경로만 볼 수 없다. 공유된 평균과 분산을 거치는 모든 경로의 기여도 합쳐야 한다.
이것이 BN backward의 핵심이다. Affine에서 sample들의 입력이 독립적이었던 것과 달리, training BN은 같은 feature의 sample들을 통계로 연결하는 연산이다.
뒤에서 주어진 값은:
구해야 할 것은 dx, dgamma, dbeta다. 평균·분산으로도 gradient가 흐르지만, 평균·분산을 optimizer가 직접 학습하는 parameter처럼 업데이트하는 것은 아니다.
9. dgamma와 dbeta는 앞 글의 affine와 같은 원리다
출력 연산부터 보자.
Gamma에 대한 local derivative는 , beta에 대한 local derivative는 1이다. 같은 gamma·beta가 여러 sample에서 공유되므로:
dgamma = np.sum(dout * x_hat, axis=0)
dbeta = np.sum(dout, axis=0)
dx_hat = dout * gammadgamma, dbeta의 shape는 parameter와 같은 (D,)다. dx_hat은 (N,D)이며 정규화 연산 쪽으로 넘길 upstream이다. 한 경로에서 upstream × local derivative, 같은 parameter로 돌아오면 합한다는 원리는 변하지 않는다.
10. dx를 계산하는 세 경로와 일반 backward
Feature 하나만 보면서 sample index를 i라고 쓰자. Forward를 작은 연산으로 나누면:
는 centered input, 은 역표준편차다. 위 코드의 xc, inv_std와 같다. 정규화 쪽의 upstream을 라고 놓는다.
첫째: variance로 돌아오는 기여
같은 variance가 모든 sample에 쓰였으므로:
둘째: mean으로 돌아오는 기여
Mean을 바꾸면 중심화 값들이 모두 바뀐다. 직접 경로와 variance를 거치는 경로를 함께 합한다.
이론적으로 중심화 값의 합은 0이지만, 계산 그래프의 경로를 그대로 쓰면 왜 두 항이 생기는지 보인다.
셋째: 입력으로 돌아오는 세 경로 합치기
첫 항은 x → centered x → x_hat의 직접 기여, 둘째는 variance 경로, 셋째는 mean 경로다. Mean과 variance는 입력으로부터 계산되므로 이 두 경로를 버릴 수 없다.
def batchnorm_backward(dout, cache):
    x_hat, gamma, xc, inv_std = cache
    N = dout.shape[0]

    dgamma = np.sum(dout * x_hat, axis=0)
    dbeta = np.sum(dout, axis=0)
    q = dout * gamma

    dvar = np.sum(q * xc, axis=0) * (-0.5) * inv_std ** 3
    dmean = -np.sum(q * inv_std, axis=0)
    dmean += dvar * np.mean(-2.0 * xc, axis=0)
    dx = q * inv_std + dvar * (2.0 / N) * xc + dmean / N
return dx, dgamma, dbetadvar, dmean은 feature별 (D,)이고 dx는 입력과 같은 (N,D)다. inv_std ** 3은 를 재사용한 것이다.
여기의 1/N은 BN이 forward에서 평균·분산을 계산한 연산 자체를 미분해서 생겼다. Softmax의 평균 loss에 들어간 1/N과는 다른 연산이다. “Loss에서 이미 평균냈으니 BN backward의 N도 없애야 한다”라고 생각하면 안 된다. 반대로 이 식을 계산한 뒤 전체 dx, dgamma, dbeta를 임의로 다시 N으로 나누지도 않는다.
11. 간소화 backward와 작은 숫자 예제
같은 미분을 정리하면 중간 dvar, dmean을 명시적으로 만들지 않는 식도 얻는다.
여전히 각 feature 안에서 sample 방향으로 합한다. 세 항은 원래의 직접·평균·분산 경로를 정리한 결과다. 새로운 gradient 규칙이 아니다.
def batchnorm_backward_alt(dout, cache):
    x_hat, gamma, xc, inv_std = cache
    N = dout.shape[0]
    dgamma = np.sum(dout * x_hat, axis=0)
    dbeta = np.sum(dout, axis=0)
    q = dout * gamma
    dx = (inv_std / N) * (
        N * q
        - np.sum(q, axis=0)
        - x_hat * np.sum(q * x_hat, axis=0)
    )
    return dx, dgamma, dbeta
이 함수는 앞의 forward와 동일한 cache를 받는다. 과제는 일반 backward와 간소화 backward의 gradient가 거의 같은지 비교하게 한다. 계산 시간이 짧을 때의 단 한 번 측정으로 일정한 speedup을 보장할 수는 없지만, 두 구현이 동일한 미분을 계산해야 한다는 조건은 분명하다.
[1, 3, 5]에 gradient를 보내 보기
, 에 대해 이었다. 뒤에서 dout=[1,2,0]이 도착했다고 하자. 이는 출력값이 아니라 loss의 출력에 대한 gradient다.
정규화 쪽의 upstream은 이다. 위 식에 넣으면 epsilon을 무시했을 때:
세 번째 sample의 dout은 0인데 dx는 0이 아니다. 세 번째 입력도 공유 평균·분산을 바꾸어 다른 sample의 출력에 영향을 주기 때문이다. 이 한 가지 예가 BN backward에서 sample들을 연결해 봐야 하는 이유를 보여준다.
12. FullyConnectedNet에는 어떻게 연결할까?
BN 함수 하나가 맞는 것과 network 전체 연결이 맞는 것은 다른 문제다. 여기서는 앞 과제의 affine·ReLU·softmax가 구현된 FullyConnectedNet에 normalization을 추가한다. 설명에서는 dropout을 끈 구조를 사용한다.
초기화: hidden layer마다 gamma·beta와 상태 하나
다음은 기존 __init__의 W, b 초기화에 추가하는 부분이다. self.num_layers는 마지막 출력 affine을 포함한 layer 수다.
if self.normalization in ("batchnorm", "layernorm"):
    for i in range(1, self.num_layers):
        width = hidden_dims[i - 1]
        self.params[f"gamma{i}"] = np.ones(width, dtype=dtype)
        self.params[f"beta{i}"] = np.zeros(width, dtype=dtype)

if self.normalization == "batchnorm":
    self.bn_params = [{"mode": "train"} for _ in hidden_dims]
elif self.normalization == "layernorm":
    self.bn_params = [{} for _ in hidden_dims]
else:
self.bn_params = []gamma1, beta1의 shape는 첫 hidden layer의 크기다. 마지막 score layer에는 gamma·beta를 만들지 않는다. bn_params[0]은 첫 hidden layer 전용 상태다. Layer마다 activation 통계가 다르므로 running 통계를 공유하면 안 된다.
gamma, beta를 self.params에 넣으면 Solver가 이 parameter들도 업데이트한다. 반대로 running mean·variance는 self.params에 넣지 않는다.
Forward: hidden block마다 Affine → Norm → ReLU
아래는 loss 메서드 안의 forward 부분이다. 15–16절에서 설명하는 LayerNorm도 같은 위치에 선택적으로 들어간다.
mode = "test" if y is None else "train"
if self.normalization == "batchnorm":
    for bn_param in self.bn_params:
        bn_param["mode"] = mode

h = X.astype(self.dtype)
caches = []
for i in range(1, self.num_layers):
    z, fc_cache = affine_forward(h, self.params[f"W{i}"], self.params[f"b{i}"])
    norm_cache = None
    if self.normalization == "batchnorm":
        z, norm_cache = batchnorm_forward(
            z, self.params[f"gamma{i}"], self.params[f"beta{i}"],
            self.bn_params[i - 1],
        )
    elif self.normalization == "layernorm":
        z, norm_cache = layernorm_forward(
            z, self.params[f"gamma{i}"], self.params[f"beta{i}"],
            self.bn_params[i - 1],
        )
    h, relu_cache = relu_forward(z)
    caches.append((fc_cache, norm_cache, relu_cache))

L = self.num_layers
scores, last_cache = affine_forward(h, self.params[f"W{L}"], self.params[f"b{L}"])
if y is None:
    return scores
Hidden block의 cache에는 affine·normalization·ReLU의 기록을 순서대로 저장한다. Test 호출에서는 현재 running 통계를 사용한 뒤 score만 반환한다. 다음 training 호출에서는 다시 mode="train"으로 바꾼다.
Backward: ReLU → Norm → Affine
Forward의 역순이다. 같은 메서드에서 이어지는 코드는 다음과 같다.
loss, upstream = softmax_loss(scores, y)
grads = {}
upstream, dW, db = affine_backward(upstream, last_cache)
grads[f"W{L}"] = dW
grads[f"b{L}"] = db

for i in range(self.num_layers - 1, 0, -1):
    fc_cache, norm_cache, relu_cache = caches[i - 1]
    upstream = relu_backward(upstream, relu_cache)
    if self.normalization == "batchnorm":
        upstream, dgamma, dbeta = batchnorm_backward_alt(upstream, norm_cache)
    elif self.normalization == "layernorm":
        upstream, dgamma, dbeta = layernorm_backward(upstream, norm_cache)
    if self.normalization in ("batchnorm", "layernorm"):
        grads[f"gamma{i}"] = dgamma
        grads[f"beta{i}"] = dbeta
    upstream, dW, db = affine_backward(upstream, fc_cache)
    grads[f"W{i}"] = dW
    grads[f"b{i}"] = db

for i in range(1, self.num_layers + 1):
    W = self.params[f"W{i}"]
    loss += 0.5 * self.reg * np.sum(W * W)
    grads[f"W{i}"] += self.reg * W
return loss, grads
이 과제에서는 L2 regularization을 weight에 적용하고 gamma·beta에는 적용하지 않는다. grads에는 self.params의 학습 parameter와 같은 이름들이 있어야 한다. gamma1을 만들고 grads["gamma1"]을 빠뜨리면 Solver가 학습할 gradient를 받지 못한다.
반면 running_mean이나 running_var의 gradient를 grads에 만들지는 않는다. 이 값들은 앞에서 정한 이동평균 규칙으로 갱신한다. Adam은 W, b, gamma, beta의 gradient를 받아 각각을 업데이트한다.
13. 과제의 검사 셀은 각각 무엇을 확인할까?
처음부터 큰 network를 오래 학습시키기보다 작은 연산부터 확인하면 오류 위치를 찾기 쉽다.
| 순서 | 확인할 것 | 결과를 읽는 방법 |
|---|---|---|
| Training forward | gamma=1, beta=0에서 feature별 평균·표준편차 | 평균은 0 근처, 표준편차는 1 근처 |
| Scale·shift forward | gamma·beta를 다른 값으로 설정 | 평균은 beta 근처, 표준편차는 gamma의 절댓값 근처 |
| Inference forward | 학습 batch들로 running 통계를 쌓고 test 모드 호출 | 현재 batch 통계로 정규화한 것처럼 정확히 0·1일 필요는 없다 |
| 일반 backward | dx·dgamma·dbeta를 수치 미분과 비교 | 같은 scalar loss를 미분한 값끼리 비교 |
| 간소화 backward | 일반 구현과 비교 | 세 gradient가 거의 같아야 한다 |
| Network 전체 | 여러 hidden layer와 regularization을 포함한 gradient check | gamma·beta 이름과 layer별 cache까지 확인 |
| 학습 실험 | BN 유무·초기화 scale·batch size 비교 | 기능 검사와 일반화 성능 평가를 구분 |
Numerical gradient는 입력을 아주 조금 바꿔 결과가 얼마나 변하는지 측정한다. dout=G가 주어졌다면 다음 scalar 함수를 생각하면 된다.
고정된 G에 대해 F를 미분한 것이 backward의 dx다. 따라서 출력이 배열인 BN도 하나의 scalar 비교 문제로 검사할 수 있다.
from cs231n.gradient_check import eval_numerical_gradient_array

np.random.seed(231)
x = 5 * np.random.randn(4, 5) + 12  # float64
gamma = np.random.randn(5)
beta = np.random.randn(5)
dout = np.random.randn(4, 5)

fx = lambda z: batchnorm_forward(z, gamma, beta, {"mode": "train"})[0]
dx_num = eval_numerical_gradient_array(fx, x, dout)
out, cache = batchnorm_forward(x, gamma, beta, {"mode": "train"})
dx, dgamma, dbeta = batchnorm_backward(dout, cache)
dx_alt, dgamma_alt, dbeta_alt = batchnorm_backward_alt(dout, cache)
이후 dx_num과 dx, 두 backward의 결과를 비교한다. Gamma·beta도 각각 조금씩 바꾸어 같은 방식으로 검사할 수 있다. 검사할 때는 float64를 사용한다. 두 gradient가 모두 매우 작은 경우 상대 오차만으로 판단하면 오해할 수 있으므로 절대 오차도 함께 본다.
전체 network에서 affine bias 바로 뒤에 BN이 있다면, training에서는 feature별 상수 이동이 평균을 빼는 연산에서 상쇄된다. 그 bias의 gradient가 매우 작게 나오는 것도 이 구조와 연결된다. 작은 값이라는 이유만으로 무조건 backward가 틀렸다고 판단하지 않는다.
자주 막히는 지점
- 정규화 축을
axis=1로 잘못 계산했다. sqrt(var + eps)대신 variance 자체로 나눴다.- Training forward에서 running 통계를 사용했다.
bn_param을 매번 새로 만들어 running 통계가 사라졌다.- Test 호출에서도 running 통계를 바꿨다.
- Forward와 backward가 서로 다른 cache 구조를 사용한다.
- ReLU와 BN backward의 순서를 바꿨다.
gamma·beta를 초기화했지만grads에 넣지 않았다.
오류를 찾을 때는 forward 통계 → 단일 layer의 미분 → network 연결 → 학습 실험 순서로 범위를 넓힌다. 긴 학습의 accuracy만 보고 어느 줄이 틀렸는지 추측하지 않는다.
14. 초기화 scale과 batch size 실험은 무엇을 묻는가?
초기화 scale: 처음 값의 크기에 얼마나 민감할까?
BN이 없는 network에서는 초기 weight의 크기가 깊은 layer의 activation과 gradient에 영향을 준다. BN을 넣으면 affine 출력의 중심·규모를 매 batch 조절하므로 초기 scale 변화에 덜 민감해지는 효과를 관찰할 수 있다.
하지만 어떤 초기화에서도 항상 같은 성능을 낸다는 뜻은 아니다. 값의 분산이 epsilon보다 아주 작거나, weight가 모두 같은 대칭 상태이거나, 다른 구현 문제가 있다면 BN 하나로 해결되지 않는다. 과제 그래프에서는 BN 유무에 따라 잘 학습되는 scale 범위와 loss·train/validation accuracy가 어떻게 달라졌는지 읽는다.
Batch size: 정규화 기준이 얼마나 안정적일까?
BN의 평균·분산은 sample들을 이용한 추정값이다. Batch가 작으면 어떤 sample이 들어왔는지에 따라 추정이 더 흔들릴 수 있다. 그러면 같은 sample도 같이 묶인 다른 sample에 따라 training 출력이 달라진다.
N=2에서도 평균·분산은 계산할 수 있다. 다만 관측값이 적어 정규화 기준이 불안정해질 수 있다. 앞에서 본 fully connected N=1은 각 feature의 분산이 0이 되는 극단적인 경우다.
과제의 batch size 비교에서는 이런 통계 효과 외에 같은 epoch 안에서 수행하는 update 횟수도 달라진다. 예를 들어 training sample 1,000개를 batch 5개씩 처리하는 것과 50개씩 처리하는 것은 한 epoch의 update 횟수가 다르다. Epoch 그래프의 차이를 전부 BN 통계 하나로만 설명하지 않는다.
Batch 통계가 주는 흔들림은 regularization과 비슷한 효과를 낼 수도 있다. 그러나 더 작은 batch가 항상 좋다거나, BN이 있으면 다른 regularization을 모두 없애도 된다고 결론 내리지는 않는다. 실제 실험의 training과 validation 결과를 함께 본다.
15. LayerNorm: sample 대신 feature 방향으로 정규화하기
수업 마지막에는 큰 입력을 처리하느라 batch를 크게 잡기 어려운 경우를 생각한다. 평균·분산을 다른 sample에 의존하지 않고 구하려면 어떻게 할까? 한 sample 안의 feature들을 사용할 수 있다.
입력이 (N,D)인 fully connected layer에서 LayerNorm은:
로 각 sample의 통계를 구한다. 정규화와 scale·shift 식은:
Gamma·beta는 여전히 feature별 (D,)다. 달라진 것은 통계를 구하는 축이다.
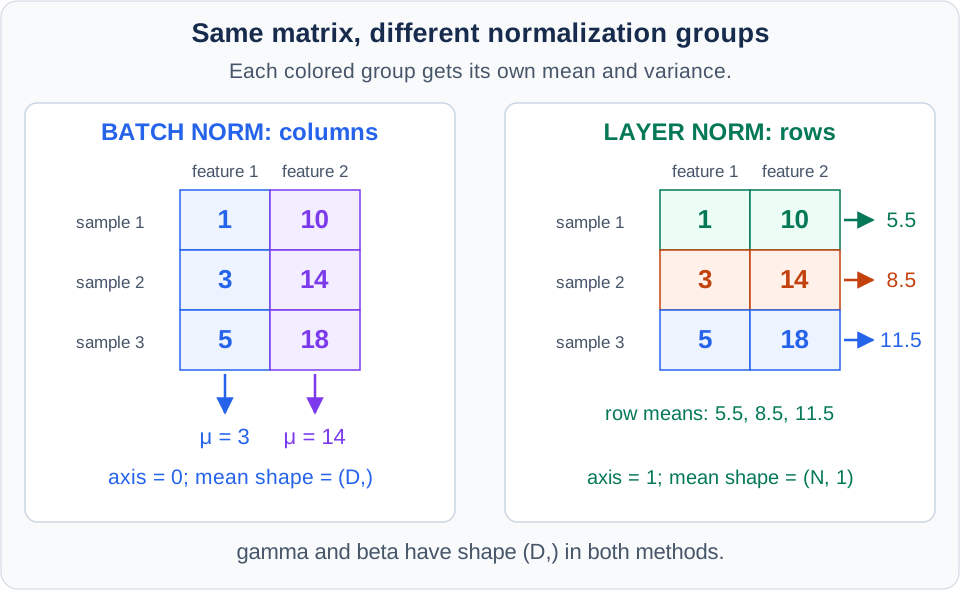
같은 색으로 묶인 값들이 평균·분산 하나를 공유한다. 왼쪽은 feature를 고정하고 sample들을 묶는 BN, 오른쪽은 sample을 고정하고 feature들을 묶는 LN이다. 어느 쪽도 입력 행렬의 shape를 바꾸지는 않는다.
| 구분 | Fully connected BatchNorm | Fully connected LayerNorm |
|---|---|---|
| 정규화 묶음 | 같은 feature의 여러 sample | 같은 sample의 여러 feature |
| 통계 계산 축 | axis=0 | axis=1 |
| 평균·분산 shape | (D,) 또는 (1,D) | (N,1) |
| Gamma·beta shape | (D,) | (D,) |
| Running 통계 | 필요 | 필요 없음 |
| Training / inference | 다른 통계 사용 | 같은 계산 |
| 다른 sample의 구성 영향 | Training에서 있음 | 이 정규화 연산 자체에는 없음 |
앞 절의 행렬에서 BN은 세로 [1,3,5]를 묶었다. LayerNorm은 가로 [1,10], [3,14], [5,18]를 각각 묶는다. 첫 sample만 보면 평균은 5.5, 분산은 20.25다. Epsilon을 무시하면 정규화값은 [-1,1]이다.
한 sample의 feature는 여러 개일 수 있으므로 batch size가 1이어도 LayerNorm은 계산할 정보가 있다. 반면 feature 수 D=1이면 한 sample 안의 분산도 0이 된다. BN이 N에 의존했다면 LN은 정규화하는 feature 묶음의 크기를 생각해야 한다.
과제에서 전처리 방법과 BN·LN의 유사성을 묻는 문제도 어느 범위의 값들을 함께 사용하느냐부터 판단한다. 여러 sample에서 통계를 공유하는지, 한 sample 안의 feature들만 사용하는지 구분하자. 값을 합이 1이 되도록 나누는 것과 평균 0·분산 1로 표준화하는 것은 같은 공식이 아니다. Threshold로 0·1을 정하는 연산 역시 이런 통계적 정규화와 구분한다.
정규화하는 feature가 매우 적으면 정보가 강하게 제거될 수도 있다. 예를 들어 서로 다른 두 값만 갖는 sample을 epsilon 없이 표준화하면 크기와 간격에 관계없이 대체로 [-1,1] 또는 [1,-1]이 남는다. 작은 feature 수가 항상 실패를 뜻하는 것은 아니지만, 정규화는 아무 정보 손실도 없는 무료 연산이 아니라는 점을 보여준다.
16. LayerNorm 코드: 축만 바꾸면 끝일까?
Forward는 mean·variance의 축을 바꾸고 running 통계를 제거하면 거의 같은 모양이다. keepdims=True를 사용하면 (N,1)을 유지하므로 (N,D)의 각 행에 자기 통계를 broadcasting할 수 있다.
def layernorm_forward(x, gamma, beta, ln_param):
    eps = ln_param.get("eps", 1e-5)
    mean = np.mean(x, axis=1, keepdims=True)
    var = np.var(x, axis=1, keepdims=True)
    inv_std = 1.0 / np.sqrt(var + eps)
    x_hat = (x - mean) * inv_std
    out = gamma * x_hat + beta
    cache = (x_hat, gamma, inv_std)
    return out, cache
Backward에서는 중요한 차이가 하나 있다. BN은 한 feature 안의 sample들을 묶으므로 그 묶음 안에서는 gamma가 같다. LN은 여러 feature를 묶으므로 같은 정규화 묶음 안에서도 gamma 값이 다를 수 있다. 따라서 gamma를 곱한 q = dout * gamma를 먼저 만든 뒤 그 q를 합해야 한다.
def layernorm_backward(dout, cache):
    x_hat, gamma, inv_std = cache
    D = dout.shape[1]
    dgamma = np.sum(dout * x_hat, axis=0)
    dbeta = np.sum(dout, axis=0)
    q = dout * gamma
    dx = (inv_std / D) * (
        D * q
        - np.sum(q, axis=1, keepdims=True)
        - x_hat * np.sum(q * x_hat, axis=1, keepdims=True)
    )
return dx, dgamma, dbetadx의 합산은 같은 sample의 feature 방향이다. 반면 dgamma·dbeta는 LN에서도 axis=0이다. Parameter는 feature별 하나이고 여러 sample이 공유하기 때문이다. “LN은 axis=1이니까 모든 sum을 1로 바꾼다”는 구현은 틀린다.
layernorm_forward는 mode로 계산을 나누지 않는다. Training과 inference 모두 현재 sample의 feature 통계를 구한다. 앞의 FullyConnectedNet에서 normalization="layernorm"을 선택하면 같은 hidden 위치에 연결할 수 있다.
17. Convolution의 normalization도 결국 축의 문제다
수업 끝의 여러 normalization 이름은 평균·분산을 계산할 값들을 어떤 묶음으로 고르느냐로 읽으면 된다. Convolution 자체를 지금 모두 다시 구현할 필요는 없다. 입력 shape에서 sample·channel·공간 축을 먼저 구분하자.
(N,C,H,W)는 sample N개, channel C개, 높이 H·너비 W의 activation map이다.
| 경우 | 같은 평균·분산에 참여하는 값 | 남는 통계 |
|---|---|---|
Fully connected BN, (N,D) | 같은 feature의 N sample | feature마다 하나 |
Fully connected LN, (N,D) | 한 sample의 D feature | sample마다 하나 |
Spatial BN, (N,C,H,W) | 같은 channel의 N·H·W 방향 | channel마다 하나 |
InstanceNorm, (N,C,H,W) | 한 sample·한 channel의 H·W 방향 | sample·channel마다 하나 |
Spatial BN은 axis=(0,2,3) 방향을 묶는다고 생각할 수 있다. 이 경우 N이 1이어도 H·W에 여러 값이 있을 수 있으므로, 앞서 본 fully connected BN의 N=1 퇴화와 조건이 같지는 않다.
수업에서 소개한 CNN의 LayerNorm은 한 sample 안에서 지정한 feature 축들을 묶는 관점이다. 정확히 어느 축과 parameter shape를 쓰는지는 정규화 대상으로 지정한 모양을 확인해야 한다. GroupNorm은 sample 안의 channel을 몇 묶음으로 나누고 각 묶음의 공간 값들과 함께 통계를 구한다.
이름만 보고 외우기보다 어느 값들을 함께 평균내고, 어느 축의 차이를 남기며, gamma·beta를 누가 공유하는지 확인하면 새로운 normalization도 읽을 수 있다. 이번 fully connected 과제 구현의 핵심은 앞의 BN·LN 두 축이다.
18. 스스로 확인할 문제
문제 1. BN을 쓰면 ReLU는 빼도 될까?
Affine → BN → ReLU에서 BN과 ReLU의 역할은 무엇인가? Adam은 어느 쪽에 들어가는가?
정답과 해설 펼치기
BN은 activation의 중심·규모를 조절하고 gamma·beta로 출력의 scale·shift를 학습한다. ReLU는 음수 입력을 0으로 보내는 activation이다. 서로 대체하는 연산이 아니다. Adam은 이 forward chain의 중간 layer가 아니라, backward가 구한 W, b, gamma, beta의 gradient로 parameter를 갱신하는 optimizer다.
문제 2. 정규화 축과 shape
BN 입력이 (64,100)이면 평균·분산, gamma·beta, 출력의 shape는 무엇인가? 통계를 구하는 NumPy 축은?
정답과 해설 펼치기
64개 sample이 같은 feature의 통계를 공유한다. mean, var, gamma, beta는 각각 (100,), 출력은 (64,100)이다. 통계는 axis=0으로 계산한다. (1,100)으로 유지해도 같은 broadcasting 의미를 만들 수 있다.
문제 3. 숫자 하나의 feature를 정규화하기
의 평균·분산과 정규화값을 구하라. 이어서 , 을 적용하라. Epsilon은 무시한다.
정답과 해설 펼치기
분산은 세 편차 제곱의 합을 N=3으로 나누어 구한다. Gamma·beta를 적용한 최종 y가 항상 평균 0·분산 1인 것은 아니다.
문제 4. Beta와 running mean은 둘 다 학습 parameter일까?
어떤 값이 optimizer로 학습되고, 어떤 값이 통계의 이동평균으로 갱신되는가?
정답과 해설 펼치기
Gamma·beta는 loss의 gradient를 받아 optimizer로 학습한다. Running mean·variance는 training batch에서 계산한 통계를 이동평균으로 누적한다. 둘 다 여러 update에 걸쳐 보존되지만 갱신 원리가 다르다. Running 통계를 self.params나 grads에 넣지 않는다.
문제 5. 예측을 한 장씩 해도 결과가 유지되려면?
학습한 모델에서 여러 입력을 한꺼번에 예측한 결과와, 각각 한 장씩 예측한 결과가 BN 때문에 달라지지 않게 하려면 무엇을 써야 할까?
정답과 해설 펼치기
mode="test"에서 저장된 running 통계와 학습한 gamma·beta를 고정해서 사용한다. 현재 prediction batch의 평균·분산을 다시 구하지 않고 running 통계도 갱신하지 않는다. Training 모드로 한 장씩 넣으면 fully connected BN의 정규화 출력은 0, scale·shift 뒤에는 beta만 남는 문제가 생긴다.
문제 6. dout이 0인데 dx는 0이 아닐 수 있을까?
BN에서 한 sample의 dout이 0일 때 그 sample의 입력 gradient도 반드시 0인가?
정답과 해설 펼치기
아니다. 그 입력이 같은 feature의 공유 평균·분산에 영향을 주고, 그 통계가 다른 sample의 출력과 loss에도 영향을 준다. 자기 출력의 직접 경로가 0이어도 다른 경로에서 contribution이 돌아올 수 있다. Mean·variance를 고정 상수로 취급하면 이 영향을 빠뜨린다.
문제 7. BN backward의 N을 없애도 될까?
Softmax에서 이미 평균 loss를 구했다. 그렇다면 BN backward에서 mean·variance 경로의 1/N은 제거해야 할까?
정답과 해설 펼치기
제거하면 안 된다. BN의 N은 forward에서 sample 평균·분산을 만든 local 연산의 미분이다. Loss 평균에서 온 배율과 역할이 다르다. 정해진 BN 미분식을 적용하고, 결과를 별도로 한 번 더 N으로 나누지는 않는다.
문제 8. LayerNorm에서는 모든 axis를 1로 바꿀까?
x.shape == (4,5)인 LN에서 통계, dx 합산, dgamma·dbeta 합산은 각각 어느 축인가?
정답과 해설 펼치기
통계는 axis=1, keepdims=True로 계산해 (4,1)을 만든다. dx에서도 같은 sample의 feature 방향인 axis=1로 합산한다. 하지만 gamma·beta는 feature마다 하나이고 sample들이 공유하므로 dgamma·dbeta는 axis=0으로 더해 (5,)를 만든다. Gamma가 feature마다 다르므로 q=dout*gamma를 만든 뒤 정규화 묶음 안에서 합한다.
문제 9. Small batch와 small feature dimension
Fully connected BN의 N=1과 LN의 D=1에서 정규화 값은 어떻게 되는가?
정답과 해설 펼치기
각 정규화 묶음에 숫자 하나밖에 없어 편차와 분산이 0이다. 정규화값은 0이고 scale·shift 뒤의 값은 beta가 된다. Epsilon 덕분에 계산 자체가 0으로 나누는 오류는 피하지만, 입력의 차이를 보존해 주지는 않는다. 어느 방향의 관측값이 부족한지 구분해야 한다.
문제 10. 구현을 마쳤는데 학습이 이상하다면?
BN 함수를 만들었고 training forward의 평균도 0에 가깝다. 이것만으로 전체 network가 올바르다고 할 수 있을까?
정답과 해설 펼치기
아니다. Gamma·beta gradient, mean·variance 경로를 포함한 dx, 일반·간소화 backward 일치, layer별 cache, mode 전환, Solver로의 parameter 전달을 각각 확인해야 한다. 그 뒤 BN 유무·초기화·batch size의 학습 실험을 해석한다. 하나의 통계가 맞는 것과 전체 학습 연결이 맞는 것은 다른 확인이다.
참고 자료
- ENPM703, Module 07b — Training Neural Networks, Part 2: Activation Functions, Data Preprocessing, Weight Initialization, Batch Normalization; 2026년 10월 15일 수업.
- ENPM703,
BatchNormalization.ipynb,layers.py,fc_net.py. - Ioffe & Szegedy, Batch Normalization, Algorithm 1; Ba, Kiros & Hinton, Layer Normalization.