앞 글의 Linear Programming에서는 목적함수가 affine이면 등고선이 평행하게 이동하고, 조건이 맞을 때 꼭짓점에서 최적값을 찾을 수 있다는 것을 보았다. 하지만 예측 오차의 제곱합이나 두 물체 사이 거리처럼 자연스러운 비용 함수에는 이차항이 등장한다.
Quadratic Programming(이차계획법, QP)은 affine 제약을 유지하면서 이런 비용을 다루는 단계다. 가능집합은 여전히 polyhedron이지만 목적함수의 곡률 때문에 최적점은 내부에도, 경계에도 놓일 수 있다. 따라서 꼭짓점만 검사하는 대신 Hessian의 PSD 조건과 제약을 고려한 최적성 조건을 함께 사용해야 한다.
작은 이차함수에서 시작해 왜 가 곡률을 결정하는지 확인하고, 제약이 있는 최소제곱과 두 다면체 사이 거리를 QP로 표현해 보자.
1. LP에서 QP로
LP는 목적함수가 affine이다.
QP는 이차항을 허용한다.
여기서 는 대칭행렬, 는 벡터, 는 상수다. 이 글의 은 앞의 LP 글에서 쓴 공의 반지름과 달리 목적함수의 상수항이다. 제약은 Affine Inequality/Equality(아핀 부등식·등식)로 표현한다. 는 각 행의 부등식을 모두 만족한다는 뜻이다.
Quadratic Programming(이차계획법, QP)은 목적함수에 이차항이 있는 최적화 문제다. 일반적인 QP가 모두 convex인 것은 아니다. 이 수업에서 주로 다루는 것은 인 Convex QP(볼록 이차계획)다.
교안 발췌 · Module 6 — Quadratic Program
Quadratic objective function
Affine constraint functions
When , reduces to a linear program
은 실수 대칭 PSD 행렬들의 집합이다. 이 기호의 는 모든 원소가 양수라는 뜻이 아니다. 이차형식이 모든 방향에서 음수가 되지 않는다는 조건이다. 이면 이차항이 사라져 LP가 된다.
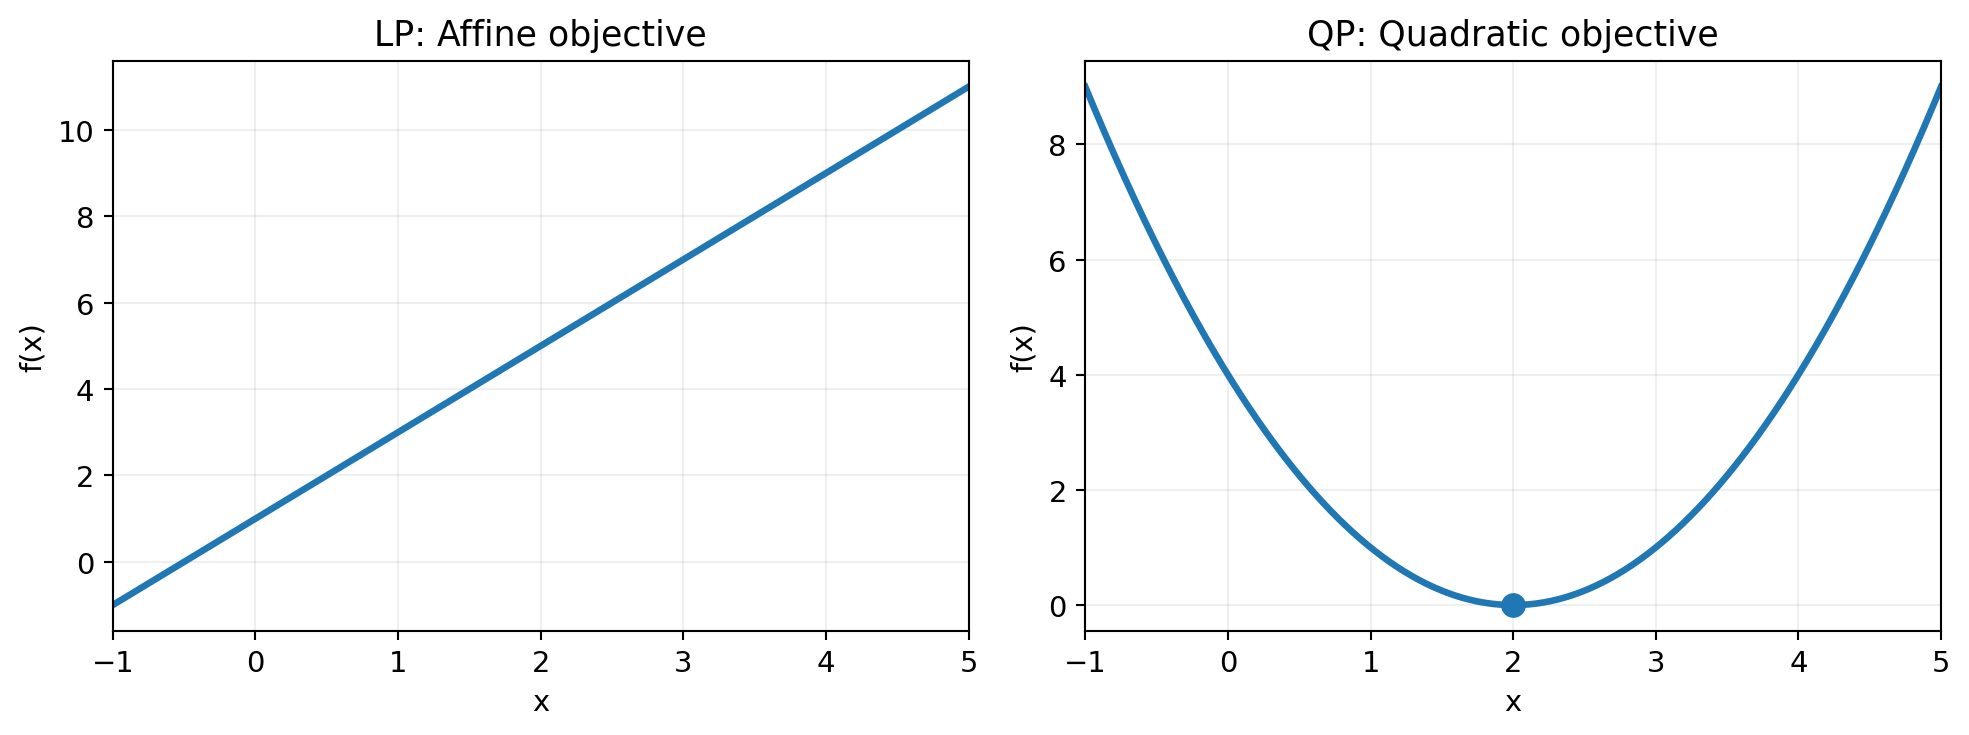
그림의 왼쪽은 , 오른쪽은 다. 앞의 직선은 기울기가 항상 2지만, 뒤의 포물선은 를 기준으로 감소하다 증가한다. 같은 축 위에서도 목적함수의 모양이 달라지면 최적점을 찾는 관점이 달라진다.
차이: LP의 gradient는 일정하지만 QP의 gradient는 위치에 따라 달라진다. 따라서 QP의 최적점은 feasible set의 내부에 있을 수도 있다.
왜 앞에 1/2이 붙고, 대칭성을 가정할까?
스칼라 를 성분으로 쓰면 다. 로 미분할 때 인 항과 인 항이 모두 기여하므로
따라서 대칭 에서는 이고, 앞의 덕분에 가 된다. 는 제약을 바꾸기 위한 장치가 아니라 미분 결과를 간단하게 만드는 관례다.
대칭이 아닌 행렬 가 주어져도
이므로 대칭 부분으로 같은 quadratic form을 나타낼 수 있다. 이때 Hessian은 자체가 아니라 다. 또 상수항 은 gradient와 최적점에는 영향을 주지 않지만, 최적값에는 더해져야 한다.
2. Quadratic Form과 고유값 복습
Quadratic Form(이차형식)은 벡터를 입력받아 하나의 실수를 만드는 식이다.
작은 예제로 시작하자.
고유벡터와 고유값의 정의는 다음과 같다.
고유벡터는 행렬 작용을 받아도 같은 직선 위에 있는 방향이다. 고유값은 그 방향에 적용되는 부호 있는 배율이다. 특히 단위 고유벡터에서는:
따라서 이차함수의 각 고유벡터 방향 곡률은 고유값의 부호로 판별할 수 있다.
- PD (positive definite): 모든 고유값이 양수. 이차 목적함수는 strictly convex.
- PSD (positive semidefinite): 모든 고유값이 0 이상. 이차 목적함수는 convex이며, 반드시 strictly convex인 것은 아니다.
- Indefinite: 양수와 음수 고유값이 공존. 이차함수는 convex하지 않다.
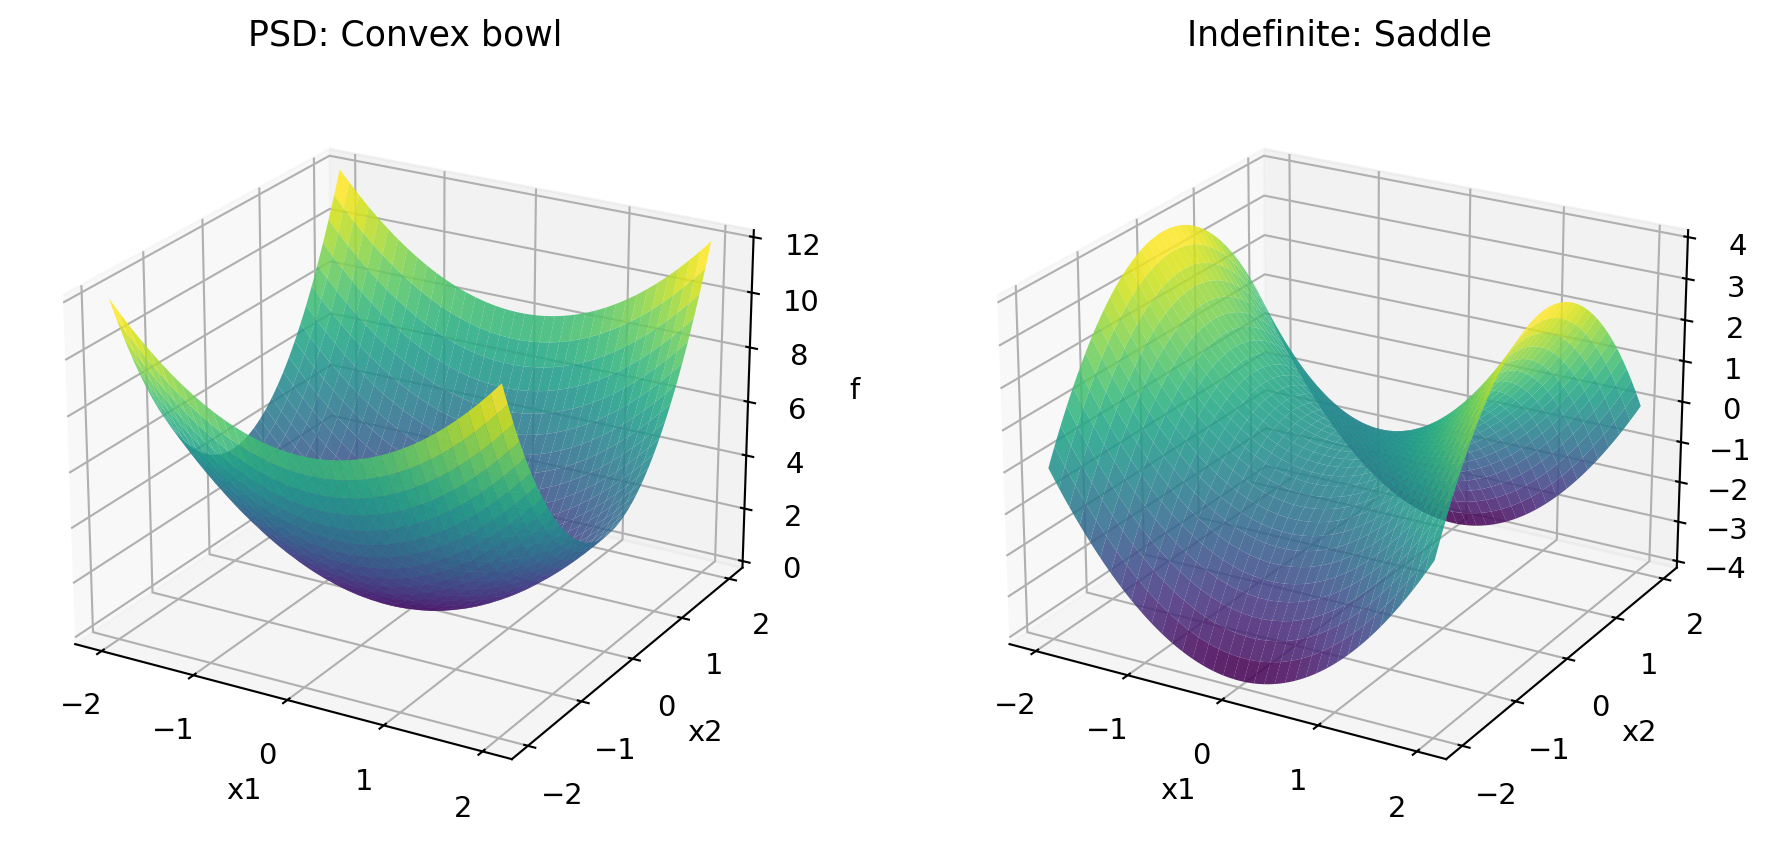
그림의 왼쪽은 다. 위에서 계산한 자체와는 배 차이가 있다. 이 예의 는 PSD인 동시에 PD여서 바닥이 한 점인 그릇 모양이다. 모든 PSD 함수가 이런 그릇 모양은 아니다. 예를 들어 는 방향으로 평평하다.
오른쪽은 이며 Hessian은 다. 한 방향으로는 위로 굽고 다른 방향으로는 아래로 굽는 Saddle(안장) 모양이다.
직접 계산: Eigenvalues
따라서 는 PD다. 방향의 고유값은 4, 방향의 고유값은 2다. 같은 거리만큼 움직여도 전자의 방향에서 목적함수가 더 가파르게 휜다.
Hessian의 PSD가 왜 convexity를 판별할까?
점 에서 방향 를 따라 움직이는 한 변수 함수 를 생각하면
이면 모든 방향에서 이 값이 0 이상이다. 어떤 직선으로 잘라도 함수가 아래로 굽지 않으므로 이차 목적함수가 convex다. 반대로 인 방향이 있으면 그 직선 위에서는 아래로 굽기 때문에 전체 에서 convex일 수 없다.
교안 발췌 · Module 6 — Quadratic Program, convexity
따라서 가 전체 에서 convex일 필요충분조건은 대칭 가 PSD인 것이다. 실제 제약이 특정 방향을 제거하는 특수한 경우와, 목적함수 자체를 전체 공간에서 판별하는 기준은 구별한다.
Convexity·존재·유일성은 다른 질문이다. 은 곡률에 관한 조건이다. 제약이 모순이면 feasible point가 없고, 비용이 아래로 무한히 감소할 수도 있다. 이면 무제약 QP는 유일한 최적점을 갖는다. 제약이 있을 때도 가능집합이 비어 있지 않은 닫힌 polyhedron이면 유일한 최적점이 존재하지만, 먼저 가능집합의 비어 있지 않음을 확인해야 한다.
3. QP 최적점은 꼭짓점이어야 할까?
그렇지 않다. LP의 affine objective 때문에 성립했던 꼭짓점 관련 논리를 QP에 적용하면 안 된다.
는 양 끝점 0과 4를 포함하는 구간, 즉 다. 최적점 2는 두 끝점 사이의 내부에 있다. 양 끝점의 비용은 각각 4지만 에서는 0이다. 따라서 꼭짓점 두 개만 검사하면 실제 해를 놓친다.
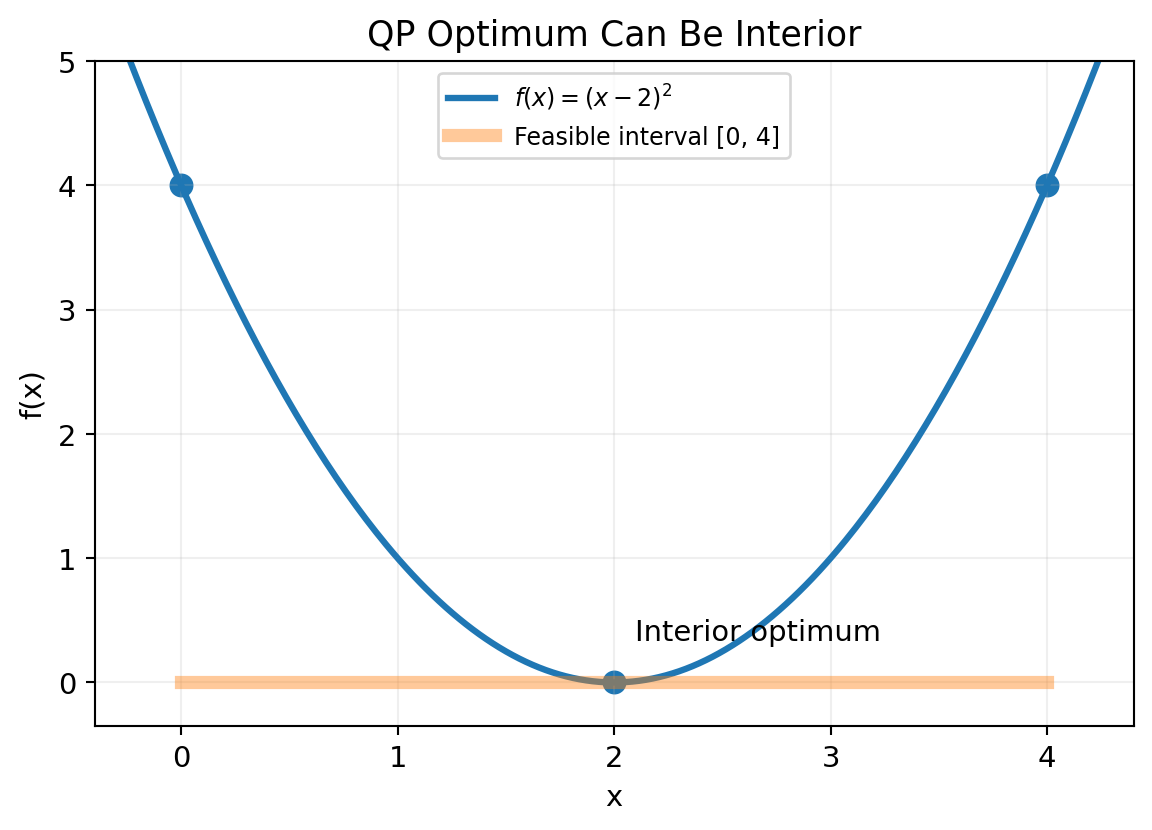
주황색 구간은 허용되는 의 범위를 표시한다. 목적함수값이 0이어야 한다는 제약이 아니라, 그 구간 위에서 포물선의 높이를 가장 낮게 만드는 를 고르는 문제다.
4. Unconstrained QP — Gradient = 0
대칭 P에 대해:
Stationary point는 다음 방정식을 만족한다.
P가 PD라면 유일한 해가 전역 최소점이다.
실전 계산에서는 역행렬을 직접 만들기보다 연립일차방정식을 푼다. 이 식을 쓰기 전에 가 가역인지 확인해야 한다.
P가 PSD이지만 singular라면?
Singular(특이)는 역행렬이 없다는 뜻이다. 이때 공식을 그대로 쓸 수 없다.
- 는 , 인 convex QP다. 이면 어느 에서도 최솟값 0이므로 최적점이 여러 개다.
- 는 같은 를 가지지만, 를 키우면 비용이 끝없이 줄어든다. PSD여도 최적점이 없다.
차이는 평평한 방향에 있는 선형항이다. 무제약 convex QP에서는 가 풀리면 그 해가 전역 최적점이고, 풀리지 않으면 유한한 최적값이 없다. 평평한 방향에 선형 감소 성분이 남으면 그쪽으로 계속 이동할 수 있기 때문이다.
예제
5. Constrained QP — Gradient가 0이 아닐 수 있다
무제약 최적점 (2,3)은 제약을 위반한다. 목적함수는 (2,3)까지의 제곱 Euclidean distance이므로, 허용된 반공간에 가장 가까운 점은 경계 위에 있다.
경계에서:
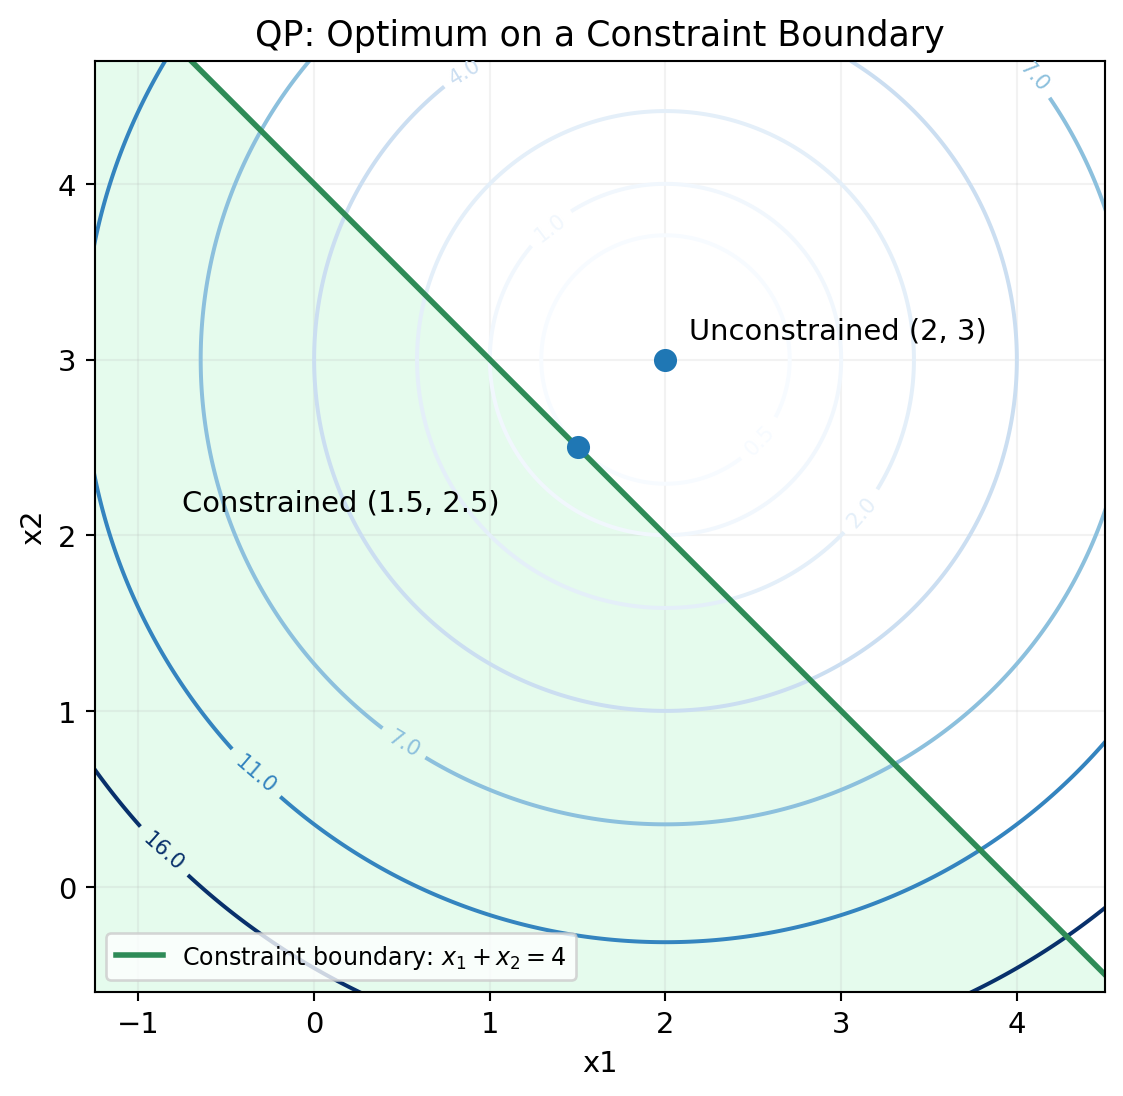
두 축은 최적화 변수 다. 원 모양의 등고선마다 목적함수값이 일정하고, 초록색 영역이 를 만족하는 반공간이다. 중심 은 영역 밖에 있으며, 가장 작은 비용으로 영역에 닿는 점이 다. 그 비용은 다.
Optimality Criterion 검증
먼저 후보점이 제약을 만족하는지 확인한다. 그다음 미분 가능한 convex 목적함수와 convex 가능집합 에서는 다음이 최적성의 필요충분조건이다.
이번 예제에서는:
마지막 부등식은 모든 feasible 가 를 만족하기 때문에 성립한다. 따라서 는 전역 최적점이다. 목적함수의 Hessian은 이므로 최적점도 유일하다.
여기서 gradient는 로 0이 아니다. 감소 방향 로 움직이면 가 커져 제약을 위반한다. 최적점은 “모든 방향에서 평평한 점”이 아니라 허용된 다른 점으로 이동해도 비용을 줄일 수 없는 점이다.
이 예에서 경계까지의 Euclidean projection(유클리드 정사영)을 쓸 수 있는 이유는 목적함수가 까지의 거리 제곱이기 때문이다. 일반적인 에서는 방향별 곡률이 달라지므로, 무제약 해를 임의로 잘라내거나 가장 가까운 Euclidean 점을 찾는 방식이 항상 해를 주지는 않는다.
6. Constrained Least Squares — 데이터 문제를 QP로
Constrained Least Squares(제약이 있는 최소제곱)는 예측 오차를 작게 만들면서 계수의 허용 범위를 지키는 문제다. 계수의 부호나 크기를 제한해야 하는 모델에서 나타난다.
교안 발췌 · Module 6 — Examples – Quadratic Program
Least squares problem with constraints (example: estimation of house values)
교안의 는 추정할 계수 벡터다. 아래에서는 데이터의 feature(입력 특성)와 구별하기 위해 계수를 로 쓴다. 아래의 관측값 두 개는 설명용 예제이며 교안의 주택가격 데이터가 아니다.
데이터:
| Feature x | Target y |
|---|---|
| 1 | 2 |
| 2 | 3 |
Bias 없는 선형 모델은 다음과 같다.
SSE(Sum of Squared Errors, 오차 제곱합)는 각 관측값과 예측값의 차이를 제곱해 더한 값이다.
이제 계수의 허용 범위를 다음과 같이 제한하자.
모든 허용 에서 이므로 비용은 오른쪽으로 갈수록 감소한다. 더 이상 오른쪽으로 갈 수 없는 이 제한된 최적점이다. 원래 오차 제곱합은 무제약 해 에서 , 제약 해 에서 다. 제약을 추가하면 가능한 선택이 줄기 때문에 최소 오차가 커질 수 있다.
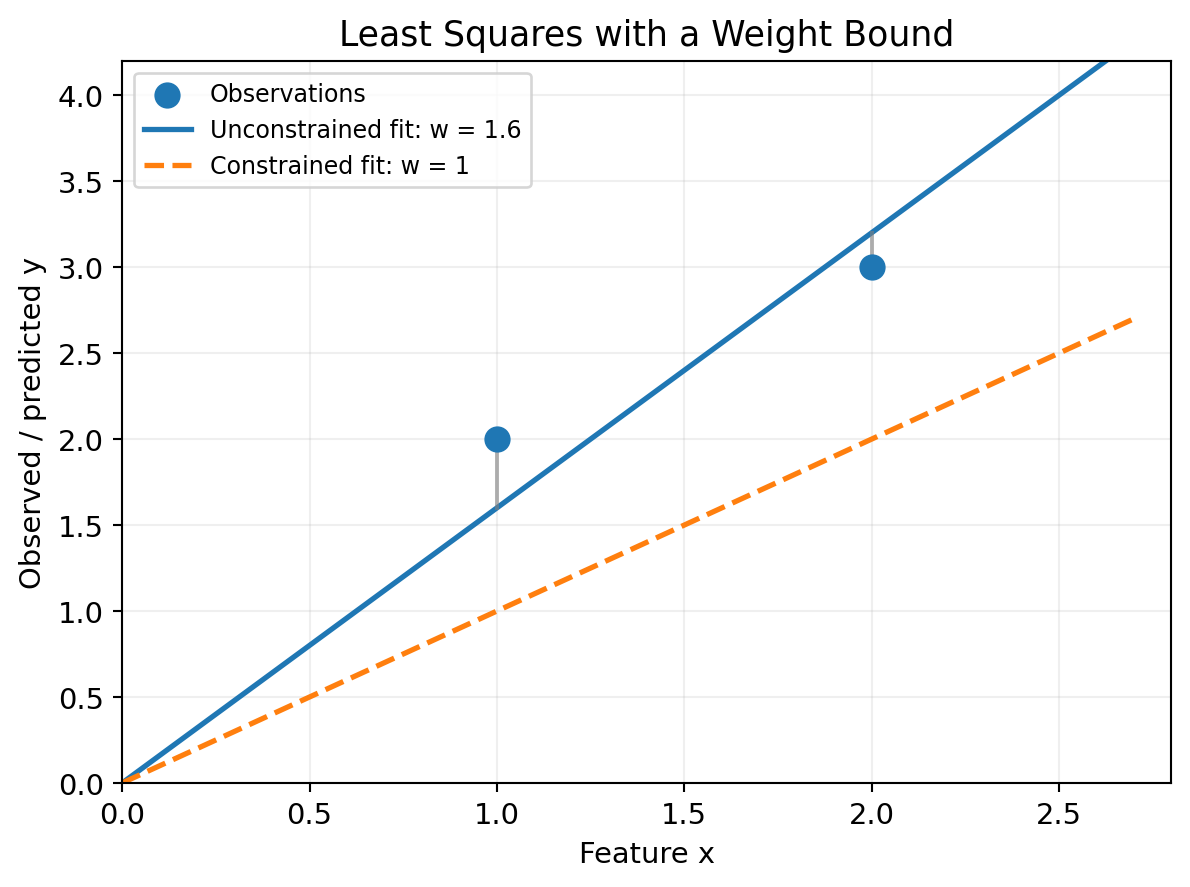
이 그림의 가로축은 최적화 변수 가 아니라 입력 feature 다. 선택할 변수 는 직선의 기울기이며, 파란 실선과 주황 점선이 서로 다른 모델을 나타낸다. 회색 세로선은 무제약 모델의 예측과 관측 사이 잔차를 표시한다. 최소화하는 것은 어느 점의 높이가 아니라 이 잔차들의 제곱합이다.
행렬 전개: QP의 P, q, r을 직접 찾기
QP 표준형과 비교:
1/2 유무에 따른 계수 차이
방금 전개한 것은 다. 교안의 에는 앞의 가 없다. 데이터 행렬과 벡터 이름을 로 통일하면 다음과 같다.
| 최소화하는 함수 | QP의 | QP의 | QP의 상수항 |
|---|---|---|---|
두 행 모두 QP 표준 목적함수는 라는 관례에 맞춘 계수다. 목적함수 전체에 양수 2를 곱해도 최적점은 같지만 최적값은 2배가 된다.
작은 예제에서 , 이므로 , , 이다. 따라서 원래 SSE는 , , 으로 표현된다.
상자 제약 는 , 라는 affine inequalities로 바꾼다. 처럼 절편을 포함하려면 데이터 행렬에 1로 된 열을 붙여 같은 방식으로 다룰 수 있다.
왜 PSD인가?
임의의 v에 대해:
따라서:
Full Column Rank(열이 선형독립)이면 인 벡터는 뿐이다. 따라서 이면 위 제곱 노름이 양수여서 이다. 반대로 열이 선형종속이면 인데도 인 방향이 있고 그 방향에서는 계수를 움직여도 예측값이 변하지 않는다.
그러므로 가 PD일 필요충분조건은 가 full column rank인 것이다. 다만 가 singular여도 제약이 평평한 방향의 움직임을 막으면 최적점이 유일할 수 있다. PSD 자체가 다중해를 강제하는 것은 아니다.
7. Distance Between Two Polyhedra — 두 번째 대표 QP 응용
두 Polyhedra(다면체) 사이 거리는 각각에서 점을 하나씩 골라 얻는 가장 작은 거리다. 두 집합을 고정해 두고 어느 두 점을 고를지를 최적화한다. 아래에서는 두 다면체가 비어 있지 않다고 가정한다.
교안도 이를 다음과 같이 QP의 응용으로 제시한다.
교안 발췌 · Module 6 — Examples – Quadratic Program, Distance between two polyhedra
교안의 두 점 를 아래에서는 로 쓴다. 각 점의 좌표와 “첫 번째 점·두 번째 점”을 혼동하지 않기 위한 표기다.
두 집합:
최적화 변수는 각각의 집합에서 고른 두 점 x, y다.
거리는 항상 0 이상이므로 거리를 제곱해도 최적점의 집합은 변하지 않는다. 그러나 최적 목적함수값은 제곱된 값이므로 마지막에 제곱근을 취한다.
작은 숫자 예제
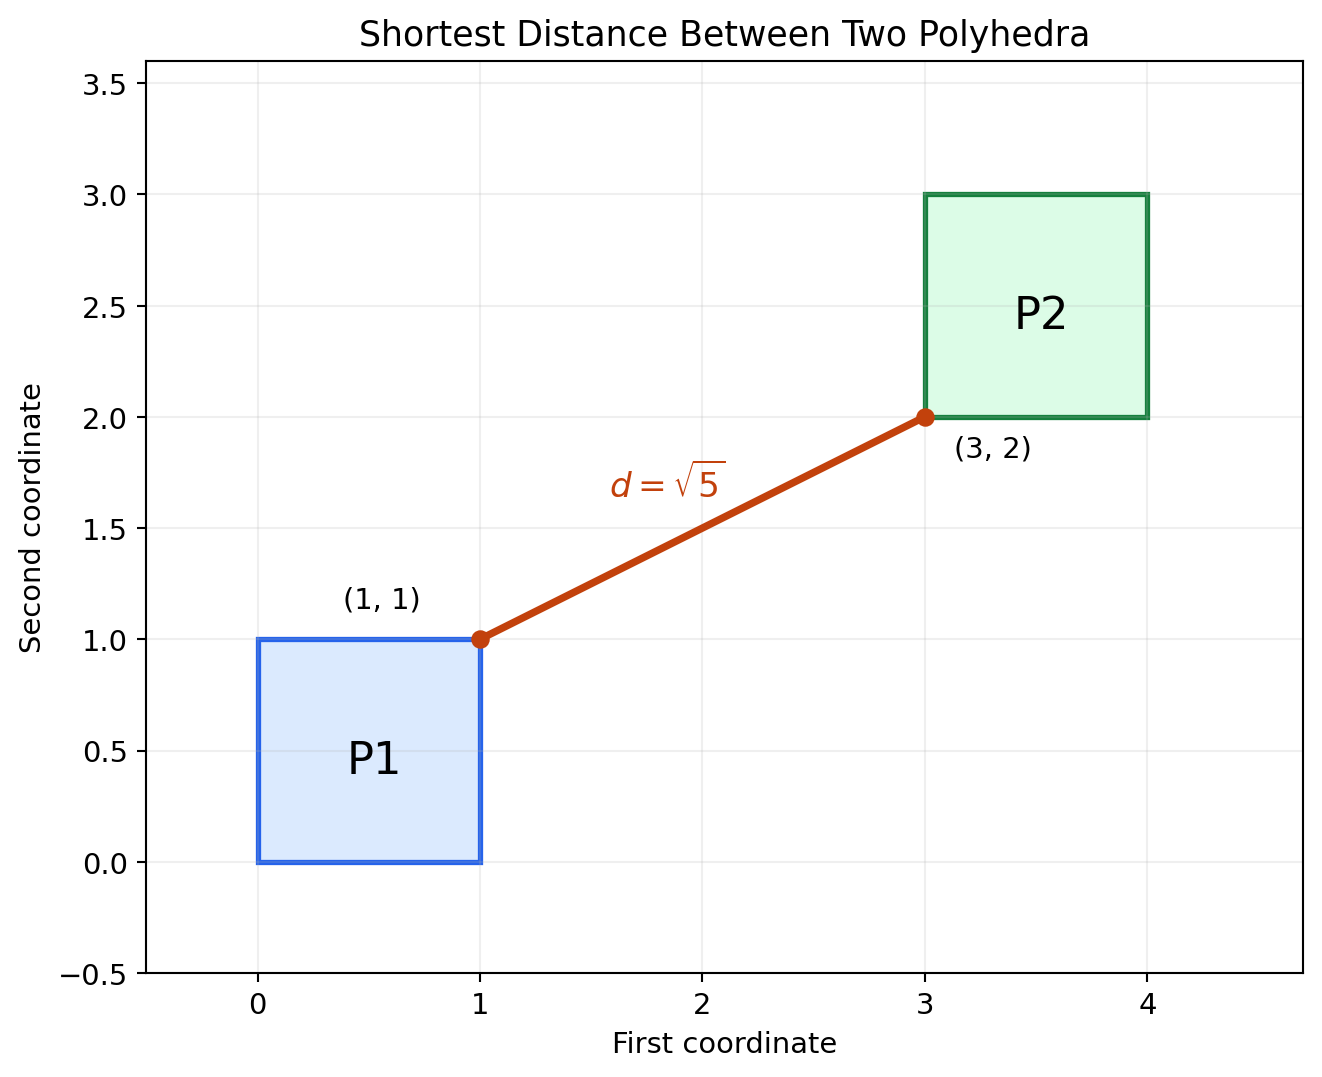
는 양 끝점을 포함하는 구간이고, 는 두 좌표의 조건을 함께 만족한다는 Cartesian Product(직접곱) 기호다. 예를 들어 은 , 인 정사각형이다.
어떤 두 점을 골라도 첫 좌표 차이는 최소 2, 둘째 좌표 차이는 최소 1이다. 따라서 제곱 거리의 하한은 다. 다음 쌍이 두 차이를 동시에 달성한다.
꼭짓점 주의: 이 예제에서는 우연히 꼭짓점 쌍이 최적인 것이며, 일반적인 QP 최단거리 쌍이 꼭짓점일 필요는 없다.
두 벡터를 하나로 쌓는 Block Quadratic Form
두 점을 하나의 Optimization Variable(최적화 변수)로 합친다. 세로로 쌓는 것이므로 각 점이 차원일 때 새 변수는 차원이다.
거리 제곱을 전개하면:
QP 표준 목적함수의 1/2에 맞추면:
여기서 는 Identity Matrix(단위행렬)다. 대각선은 각 점의 자기 제곱 를 만들고, 두 비대각 블록 는 각각 를 만들어 교차항 가 된다.
제약조건은 Block Diagonal Matrix(블록 대각행렬)로 합친다. 첫 블록 행은 에 대한 제약만, 둘째는 에 대한 제약만 계산하도록 나머지 부분을 0으로 채운 것이다.
PSD를 증명하자
임의의 z에 대해:
따라서 는 PSD이며 전체 문제는 convex QP다. 단, 인 벡터를 대입하면 인데 이차형식이 0이므로 는 PD가 아니다. 행렬의 PD 여부는 모든 벡터에서 판별하므로, 이 검사용 벡터가 실제 두 집합의 제약을 만족할 필요는 없다.
이유를 기하학적으로도 볼 수 있다. 두 점을 같은 벡터 만큼 평행이동하면 여서 거리 목적함수는 변하지 않는다. 이 공통 이동이 이차형식의 평평한 방향이다. 그러나 실제 제약은 그런 이동을 막을 수 있다. 위 두 정사각형 예제에서는 가 singular여도 최단거리 쌍은 로 유일하다.
제곱 거리 QP의 최적값을 라고 기록했다면 실제 거리는 다. 두 집합이 겹치면 공통점에서 를 골라 거리 0을 얻는다. 공통점이 여러 개라면 최적 쌍도 여러 개일 수 있다.
8. LP ↔ QP 대비
| 주제 | LP | QP |
|---|---|---|
| Objective | ||
| Gradient | 일정한 | |
| Hessian | Zero matrix | P |
| Convex 여부 | Affine objective라 항상 convex | 대칭 P의 PSD 확인 필요 |
| Feasible set | Polyhedron | Polyhedron |
| 최적점 위치 | 최적점이 존재하고 극점이 있는 경우 극점 해 존재 | 내부 혹은 경계; 꼭짓점에 한정하지 않음 |
| 증명 도구 | Optimality Criterion | Optimality Criterion, PSD, 이후 KKT |
9. 혼자 풀어 보는 확인 문제
1. 행렬의 교차항과 곡률 구분하기
, , 일 때 를 성분으로 전개하고 convexity를 판별해 보자.
정답과 해설 펼치기
정답: 이고 strictly convex다.
행렬곱의 비대각 항은 와 두 개다. 따라서 이며 마지막에 전체를 배 한다. 의 고유값은 2, 4로 모두 양수여서 다. 이차 목적함수의 Hessian은 이므로 strict convexity를 얻는다.
2. PSD와 최적점 존재는 같은 말일까?
를 전체 에서 최소화한다. 이 함수는 convex일까? 최적점도 있을까?
정답과 해설 펼치기
정답: Convex이지만 최적점은 없다.
Hessian은 다. 하지만 , 로 두면 다. Gradient 방정식은 인데 두 번째 성분을 0으로 만들 수 없다. 평평한 방향의 선형항이 비용을 끝없이 감소시킨다.
3. 경계 최적점에서 Gradient가 0이어야 할까?
5절 문제의 후보점 에서 gradient와 최적성 조건을 계산해 보자.
정답과 해설 펼치기
정답: Gradient는 이지만 전역 최적점이다.
먼저 이므로 feasible하다. 모든 feasible 는 를 만족하므로
목적함수와 가능집합이 convex이므로 이 조건이 전역 최적성을 보장한다. 무제약 최소점의 gradient 조건을 제약 문제에 그대로 강요하면 이 답을 잘못 배제하게 된다.
4. 최소제곱 앞의 1/2을 없애면?
를 로 바꿀 때, QP의 와 최적점·최적값은 각각 어떻게 달라질까?
정답과 해설 펼치기
정답: 는 모두 2배가 되고, 가능집합이 같으면 최적점은 같고 최적값은 2배다.
, , 에서 , , 로 바뀐다. 목적함수 전체에 양수를 곱했으므로 두 점의 비용 대소관계는 변하지 않는다. 6절의 예에서는 두 함수 모두 이고, 최적값은 각각 1과 2다. 최적점과 최적값을 구분해야 이 계수 차이를 놓치지 않는다.
5. 거리 문제의 P는 왜 2M일까?
라 하자. 목적함수 를 QP 표준형으로 쓸 때 이라고 적으면 무엇이 달라질까?
정답과 해설 펼치기
정답: 표준형에 앞의 가 있으므로 은 원래 거리 제곱의 절반을 최소화하는 식이다. 원래 목적값을 보존하려면 이어야 한다.
이므로 가 원래 식과 같다. 이어도 최단거리 쌍은 같지만, 정사각형 예제의 최적값은 5가 아니라 로 기록된다. 그 값을 그대로 제곱근 취하면 실제 거리를 잘못 계산한다.
10. 풀이 전후에 확인할 것
- Quadratic form의 행렬곱을 성분으로 전개할 수 있다.
- 으로 작은 행렬의 eigenvalues를 구한다.
- PSD와 PD를 구분한다.
- QP objective의 gradient / Hessian을 계산한다.
- Convexity를 Hessian=PSD로 판별한다.
- 제약조건 안의 최적해를 계산하고 Optimality Criterion으로 검증한다.
- Least Squares의 를 전개한다.
- 가 PSD라는 증명을 재현한다.
- 두 Polyhedra의 squared distance를 block matrix로 변환한다.
- Polyhedra 거리 문제에서 P가 PSD이지만 PD는 아님을 설명한다.
11. QP가 다음 최적화 방법의 도구가 되는 이유
QP는 이차 비용을 가진 모델을 푸는 데 직접 쓰인다. 더 나아가 복잡한 비선형 목적함수도 현재 점 근처에서 2차 Taylor 모형으로 근사할 수 있다.
여기서 현재 점 를 고정하고 이동량 를 변수로 보면 이차 목적함수가 된다. 수업에서는 이런 작은 이차 문제를 풀고 현재 점을 갱신하는 방식이 이후 수치 최적화 방법의 기반이 된다고 설명한다. 다만 일반 비선형 함수의 Hessian이 항상 PSD인 것은 아니므로, 이차 근사라는 사실만으로 convex QP가 되는 것은 아니다.
지금 단계에서는 세 가지를 구별하면 된다. 는 곡률을, 는 현재 위치의 gradient를, affine 제약은 이동 가능한 영역을 결정한다. 이 셋을 함께 봐야 내부·경계의 최적점과 최소제곱·거리 모델을 같은 원리로 해석할 수 있다.
출처와 보충 범위
- ENAI601 Module 6 — Examples 교안, Quadratic Program 및 Examples – Quadratic Program 절. 교안 발췌는 원래의 표현·수식을 별도 블록에 표시했다.
- 2026년 10월 7일 수업: QP의 Hessian과 PSD, 곡선 등고선, 제약 최소제곱, 두 다면체 사이 거리와 이차 근사를 활용한 후속 최적화 설명을 참고했다.
- 제공된 QP 스터디 노트와 그림 6개를 바탕으로 정리했다. 그림의 구체적인 함수와 데이터 두 개, 반공간 제약의 최적점, 두 정사각형의 거리는 설명용 예제이며 교안의 원래 수치가 아니다.
- 대칭 부분과 미분의 유도, singular PSD의 반례, 존재·유일성의 구분, 유무의 계수 비교와 확인 문제 해설은 개념을 연결하기 위한 보충 설명이다.